Despliegue en el servidor: qué significa en palabras simples
Lanzamos el código en producción. ¿Cómo se hace esto? Hablamos sobre la automatización y el despliegue sin "tiempo de inactividad".
El despliegue es el proceso de "implementación" de un servicio web, como un sitio web, en un entorno de trabajo. El entorno de trabajo es el lugar donde el sitio web se ejecuta y está disponible para las solicitudes. Puede ser un hosting listo para usar o su propia infraestructura de servidor.
No solo los servicios web se despliegan, sino también cualquier servicio accesible a través de la red. Incluso si esta red es interna y no está disponible para solicitudes a través de Internet.
Para comprender el despliegue, es necesario comprender el ciclo de vida del código. El código de la aplicación se desarrolla en la máquina de trabajo del desarrollador, pero se ejecuta en otro lugar llamado producción. Producción es el entorno de ejecución (a veces se le llama entorno de producción). En el caso de una aplicación simple, puede consistir en un solo servidor, pero puede haber miles o decenas de miles en el caso de aplicaciones realmente complejas.
Cómo sucede esto. Los desarrolladores agregan código al repositorio. En algún momento, deciden que es hora de llevarlo a producción. Esto puede suceder según un horario regular, como una vez cada dos semanas, o simplemente según sea necesario, incluso después de cada cambio. En gran medida, la cantidad de despliegues depende del nivel de automatización, es decir, de lo fácil que sea el proceso de implementación y reversión en caso de problemas. En los equipos con un buen nivel de automatización, como suele ocurrir en Códica, los despliegues se realizan con mucha frecuencia, a menudo después de cada cambio.
Cada vez que los desarrolladores deciden que todo está listo, crean una versión. Por lo general, una versión se entiende como una etiqueta en Git que registra qué se implementará. Es decir, los cambios agregados al maestro después de crear la etiqueta no afectarán la etiqueta en sí, por lo que estamos seguros de lo que estamos implementando.
{/* image */}
Para sitios web estáticos o front-end independientes (solo HTML, CSS y archivos estáticos), el despliegue se reduce a actualizar el código en el servidor. En el caso del back-end, al menos se conecta una base de datos. En general, el despliegue puede ser un procedimiento complicado que lleva mucho tiempo. En sistemas distribuidos que constan de muchos servicios web independientes, no hay un despliegue general, y cada parte de la aplicación se implementa por separado.
Vale la pena mencionar que las plataformas PaaS, como Render, Railway o Fly.io (y Vercel o Netlify para el front-end), se encargan en gran medida del despliegue. Solo necesitas hacer un commit y todo lo demás sucede de forma automática. El precio por esto es el costo de la plataforma misma, y las tarifas y condiciones cambian, por lo que conviene revisarlas en el sitio de cada proveedor. Heroku, durante años el ejemplo clásico de PaaS, pasó en 2026 a un modo de mantenimiento, según anunció Salesforce, es decir, sin nuevas funciones.
Pasos del despliegue
Entrega de código al servidor
Existen diferentes formas de entregar código al servidor según la forma en que se empaqueta. A veces, simplemente copian el código en el servidor como un conjunto de archivos, pero esto es raro, más a menudo se actualiza a través de Git. Anteriormente, el método de implementación a través de los administradores de paquetes estándar de las distribuciones de Linux era popular. Ahora también se encuentra y es el más adecuado para situaciones específicas.
- Git (
git checkout tag-name) - Docker (
docker pull image-name:tag-name) - Apt, el administrador de paquetes (
apt install application-package-name)
Actualización de la base de datos
Por lo general, una nueva versión de la aplicación requiere cambios en la base de datos. Para esto, durante (o antes) del despliegue, se ejecutan migraciones, que son scripts especiales que contienen reglas para actualizar la base de datos. Por ejemplo, estos scripts SQL.
CREATE TABLE car (
    id INT NOT NULL PRIMARY KEY,
    license_plate VARCHAR NOT NULL,
    color VARCHAR NOT NULL
);

ALTER TABLE owner ADD driver_license_id VARCHAR;
Inicio y detención
En algún momento de este proceso, se detiene la versión anterior y se inicia la nueva. Si primero detiene la versión anterior, luego ejecuta las migraciones y luego inicia la nueva, obtendrá un tiempo de inactividad en el servicio. Así es como funcionan muchos proyectos, pero esto puede ser perjudicial para el negocio y los despliegues frecuentes. Por lo tanto, los proyectos más avanzados no se detienen durante el despliegue. Sobre cómo hacer esto, a continuación.
Automatización
El despliegue debe ser automatizado al máximo, esto afecta el Time To Market, una característica clave de las aplicaciones orientadas al negocio. Cuanto más rápido y con más frecuencia entreguemos cambios al usuario, mejor. Verificamos hipótesis más rápido, realizamos correcciones más rápido, justificamos el dinero invertido en desarrollo más rápido. Sin automatización, los desarrolladores temen realizar despliegues, se convierte en una carga, lo que lleva a una disminución en el número de despliegues y estrés regular para todo el equipo, con quedarse en el trabajo hasta altas horas de la noche.
Hay tres formas principales de automatización.
- Con herramientas creadas para lenguajes específicos. Por ejemplo, en Ruby, esto es Capistrano, una de las primeras y más conocidas herramientas de este tipo, que se hizo popular mucho más allá de Ruby. El principal problema con tales herramientas es su fuerte dependencia del lenguaje.
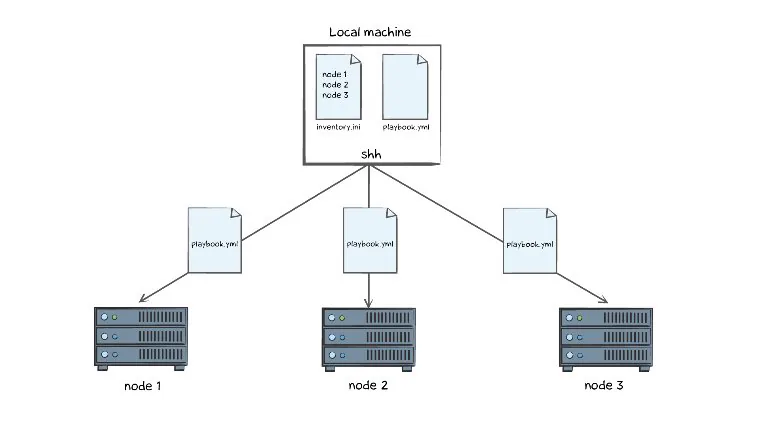
- Con Ansible, que cuenta con un módulo para el despliegue (deploy_helper), incluido en la colección community.general. Puede servir en situaciones de implementación en servidores administrados.
- Sistemas de orquestación como Kubernetes. Si se utilizan, no hay despliegue automático sin ellos.
Pero incluso si la automatización está completa, todavía queda la tarea de "iniciar el despliegue". El inicio también se automatiza. Existe todo un enfoque llamado Entrega Continua (continuous delivery). Es difícil de implementar y no es adecuado en todas partes, pero si tiene éxito, se olvidan del despliegue. Se ejecuta completamente por sí mismo sin intervención humana. Lo más importante en este caso es tener un buen monitoreo y un sistema de alerta para reaccionar a los errores.
# https://docs.ansible.com/projects/ansible/latest/collections/community/general/deploy_helper_module.html#examples
- name: Initialize the deploy root and gather facts
  community.general.deploy_helper:
    path: /path/to/root
- name: Clone the project to the new release folder
  ansible.builtin.git:
    repo: ansible.builtin.git://foosball.example.org/path/to/repo.git
    dest: '{{ deploy_helper.new_release_path }}'
    version: v1.1.1
- name: Add an unfinished file, to allow cleanup on successful finalize
  ansible.builtin.file:
    path: '{{ deploy_helper.new_release_path }}/{{ deploy_helper.unfinished_filename }}'
    state: touch
Cómo se hace hoy
En muchos equipos el despliegue se automatiza con una plataforma de integración y entrega continuas, como GitHub Actions o GitLab CI. El flujo habitual es el siguiente. Cada cambio en el repositorio dispara un pipeline que ejecuta las pruebas, construye una imagen de Docker y la publica en un registro. Después, esa imagen se despliega en una plataforma PaaS o en un orquestador como Kubernetes. Si quieres practicar el primer paso, puedes empezar con el curso GitHub Actions de Códica.
En los equipos que usan Kubernetes también se emplea el enfoque GitOps, en el que el estado deseado del sistema se guarda en un repositorio Git y herramientas como Argo CD o Flux lo aplican en el clúster. La infraestructura (servidores, redes, bases de datos) suele describirse como código con herramientas como Terraform. Para el servidor y el alojamiento, consulta también la guía de hosting.
Estas herramientas cambian con rapidez, así que lo importante es entender el principio, que es automatizar la entrega y poder volver atrás si algo falla.
Despliegue sin tiempo de inactividad
Si no se toman medidas especiales, cada despliegue resultará en una interrupción (posiblemente parcial) del servicio. Durante este tiempo, los usuarios verán un error o un mensaje sobre la actualización en curso. Pero esto no sucede en la mayoría de los servicios web importantes en Internet. ¿Por qué? Debido a la implementación del enfoque "despliegue sin tiempo de inactividad" (downtime - tiempo de inactividad del servicio).
El despliegue sin tiempo de inactividad parece como si el servicio nunca se detuviera, pero aún se actualiza. Esto se logra ejecutando simultáneamente las versiones antigua y nueva del código. Es decir, cuando se implementa una aplicación, primero se inicia una nueva versión junto con la antigua. Y solo cuando la automatización se asegura de que la nueva versión se ha iniciado y está funcionando, se detiene la versión antigua. Para realizar este procedimiento, necesitarás cuatro cosas.
- Infraestructura. Necesita un balanceador de carga que pueda cambiar el tráfico (conexiones entrantes de navegadores u otros sistemas) entre las versiones antigua y nueva del código. Y es deseable tener al menos dos servidores, aunque no es obligatorio.
- Despliegue. El proceso de despliegue sin tiempo de inactividad es mucho más complicado que con una parada. La forma más fácil de hacer esto es en sistemas de orquestación como Kubernetes. Allí, la actualización gradual (rolling update) reemplaza las instancias antiguas por las nuevas poco a poco. Existen también estrategias como blue-green, donde se mantienen dos entornos completos y se cambia el tráfico de uno al otro, y canary, donde la nueva versión recibe primero una pequeña parte del tráfico.
- Cultura de código. No se puede lograr un funcionamiento sin interrupciones sin una cultura específica de escritura de código. Para que las versiones antigua y nueva puedan funcionar al mismo tiempo, es necesario controlar todas las interfaces. Es importante cumplir con la compatibilidad inversa (trabajar con API, base de datos, colas y, en general, cualquier almacenamiento).
- Base de datos. Debe ser compatible hacia atrás entre la versión antigua y la nueva. Todas las migraciones solo hacia adelante (¡no se pueden revertir!) y solo para agregar. No se pueden eliminar ni actualizar (renombrar, cambiar el tipo) columnas y tablas.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: tomcat-deployment-${TARGET_ROLE}
spec:
  replicas: 2
  selector:
    matchLabels:
      app: tomcat
      role: ${TARGET_ROLE}
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 0
      maxSurge: 1
  template:
    metadata:
      labels:
        app: tomcat
        role: ${TARGET_ROLE}
    spec:
      containers:
      - name: tomcat-container
        image: tomcat:${TOMCAT_VERSION}
        ports:
        - containerPort: 8080
        readinessProbe:
          httpGet:
            path: /
            port: 8080
En este manifiesto, apps/v1 es la versión actual de la API para los Deployment (la antigua extensions/v1beta1 se eliminó en Kubernetes 1.16). El campo selector es obligatorio, y con maxUnavailable: 0 Kubernetes no detiene ninguna instancia hasta que la nueva supera la comprobación readinessProbe.
Recursos adicionales
- Estrategias de despliegue
- Despliegue de Ansible